

Actualizado el 3 de agosto de 2026. La API de OpenAI permite integrar modelos de texto, visión y otras capacidades en una aplicación mediante solicitudes desde un servidor. Esta guía explica una primera integración con la Responses API, añade controles básicos de seguridad y documenta una prueba propia: 12 de 12 casos superados, incluidos 10 resultados estructurados con coincidencia exacta de esquema y un error HTTP 400 provocado de forma segura.
Si estás eligiendo un modelo para una integración nueva, consulta nuestra guía de precios y modelos GPT-5.6, que reúne precios de contexto corto y largo, capacidades y resultados de prueba.
Importante: la denominación correcta es API de OpenAI. ChatGPT es un producto de OpenAI, mientras que la API es la interfaz para desarrolladores. No coloques una clave de API en JavaScript que se ejecute en el navegador, una aplicación móvil sin servidor seguro ni un repositorio público.
Qué es la API de OpenAI
Una aplicación envía una solicitud autenticada a un endpoint de OpenAI y recibe una respuesta que puede contener texto, datos estructurados o resultados de herramientas, según el modelo y la configuración. El inicio rápido oficial utiliza la Responses API para la primera llamada.
La arquitectura mínima recomendada es:
- El navegador o la aplicación cliente envía la entrada a tu servidor.
- El servidor valida la entrada, aplica límites y recupera la clave desde una variable de entorno.
- El servidor llama a la API de OpenAI.
- El servidor valida la salida antes de devolver únicamente lo necesario al cliente.
Este límite entre cliente y servidor evita exponer el secreto y permite controlar autenticación, presupuesto, abuso, registros y datos personales.
Requisitos para empezar
- Una cuenta de OpenAI Platform y un proyecto para la aplicación.
- Una clave del proyecto con los permisos mínimos necesarios.
- Facturación y límites de gasto configurados según el uso previsto.
- Node.js y el SDK oficial, o un entorno compatible con solicitudes HTTPS.
Crea la clave desde el panel enlazado en el quickstart, cópiala una sola vez y guárdala como secreto. No la pegues en capturas, tickets, analítica ni contenido de WordPress. Si una clave se expone, revócala y crea otra.
Primera llamada con Responses API
Instala el SDK oficial para JavaScript:
npm install openaiDefine OPENAI_API_KEY en el entorno del servidor. El ejemplo también usa un secreto propio, SAFETY_ID_SECRET, para generar un identificador seudónimo estable por usuario. No uses el correo, el teléfono ni otro dato personal en claro.
import OpenAI from "openai";
import { createHmac } from "node:crypto";

const client = new OpenAI({
  apiKey: process.env.OPENAI_API_KEY,
});

function makeSafetyIdentifier(appUserId) {
  const secret = process.env.SAFETY_ID_SECRET;
  if (!secret) throw new Error("Falta SAFETY_ID_SECRET");

  return createHmac("sha256", secret)
    .update(String(appUserId))
    .digest("hex");
}

const safetyIdentifier = makeSafetyIdentifier("usuario-interno-4821");

const response = await client.responses.create({
  model: "gpt-5.6-luna",
  input: "Resume en dos frases por qué conviene validar una salida de IA.",
  store: false,
  max_output_tokens: 220,
  safety_identifier: safetyIdentifier,
});

if (response.status === "incomplete") {
  throw new Error(`Respuesta incompleta: ${response.incomplete_details?.reason}`);
}

console.log(response.output_text);
Qué hace cada control
model: fija el modelo que ejecutará la solicitud. Usa un identificador explícito en pruebas reproducibles.input: contiene las instrucciones y datos enviados al modelo.store: false: solicita no conservar la respuesta como estado de aplicación. No equivale a Zero Data Retention.max_output_tokens: establece un máximo de tokens de salida. Debes gestionar respuestas incompletas cuando el límite se alcance.safety_identifier: para aplicaciones con usuarios finales individuales, la guía de modelos recomienda un valor estable y respetuoso con la privacidad.
La guía oficial de GPT-5.6 recomienda Responses API para razonamiento, herramientas y flujos de varios turnos. No copies un modelo de un tutorial antiguo sin comprobar disponibilidad, precio y comportamiento en la lista oficial de modelos.
Structured Outputs: JSON que sigue un esquema
Pedir “devuelve JSON” no garantiza que los campos y tipos coincidan con lo que espera la aplicación. Structured Outputs permite definir un JSON Schema estricto. Para estructurar la respuesta del modelo, la documentación oficial utiliza text.format con type: "json_schema", strict: true y un esquema compatible.
const ticketSchema = {
  type: "object",
  properties: {
    ticket_id: { type: "string" },
    category: {
      type: "string",
      enum: ["billing", "technical", "access", "privacy", "other"],
    },
    priority: {
      type: "string",
      enum: ["low", "medium", "high"],
    },
    requires_human: { type: "boolean" },
    next_action: { type: "string" },
  },
  required: [
    "ticket_id",
    "category",
    "priority",
    "requires_human",
    "next_action",
  ],
  additionalProperties: false,
};

const response = await client.responses.create({
  model: "gpt-5.6-luna",
  input: [
    {
      role: "system",
      content: "Clasifica el ticket usando solo los datos proporcionados.",
    },
    {
      role: "user",
      content: "Ticket T-104: no puedo acceder a mi cuenta; plazo 12 horas.",
    },
  ],
  text: {
    format: {
      type: "json_schema",
      name: "support_ticket",
      schema: ticketSchema,
      strict: true,
    },
  },
  store: false,
  max_output_tokens: 300,
  safety_identifier: safetyIdentifier,
});

if (response.status !== "completed") {
  throw new Error(`Estado no completado: ${response.status}`);
}

const ticket = JSON.parse(response.output_text);

// El esquema reduce errores de forma, pero la aplicación
// todavía debe validar las reglas de negocio y el contenido.
console.log(ticket);
La guía oficial de Structured Outputs distingue dos usos: function calling para conectar el modelo con funciones o herramientas, y text.format para estructurar la respuesta que recibe el usuario o la aplicación. Los SDK también ofrecen helpers como responses.parse para trabajar con esquemas tipados.
Un esquema válido no prueba que una afirmación sea verdadera. Comprueba reglas de negocio, permisos, cantidades, fechas y referencias contra la fuente autorizada. También contempla rechazos y respuestas incompletas.
Prueba original de la API de OpenAI: 12 de 12
Ejecutamos una prueba reproducible con datos sintéticos para comprobar los tres comportamientos centrales de esta guía. Se usó gpt-5.6-luna y el endpoint POST /v1/responses. No se enviaron datos personales, archivos, herramientas ni búsquedas.
Diseño fijado
- 1 solicitud de texto simple en español.
- 10 solicitudes de Structured Outputs, cada una con un ticket sintético y una respuesta esperada determinista.
- 1 solicitud deliberadamente inválida con
max_output_tokens: 0para observar un HTTP 400 de validación sin afectar datos ni recursos externos. store: false, máximo de salida explícito ysafety_identifierseudónimo estable en todas las solicitudes.- Sin reintentos automáticos, de modo que un fallo no quedara oculto.
Resultados medidos
| Comprobación | Resultado |
|---|---|
| Pruebas superadas | 12 de 12 |
| Respuestas HTTP 200 esperadas | 11 de 11 |
| Structured Outputs válidos por esquema | 10 de 10 |
| Coincidencias exactas con la respuesta esperada | 10 de 10 |
| Error HTTP 400 intencional | Observado correctamente, 1 de 1 |
| Latencia media | 2.636 ms |
| Latencia mediana | 2.535 ms |
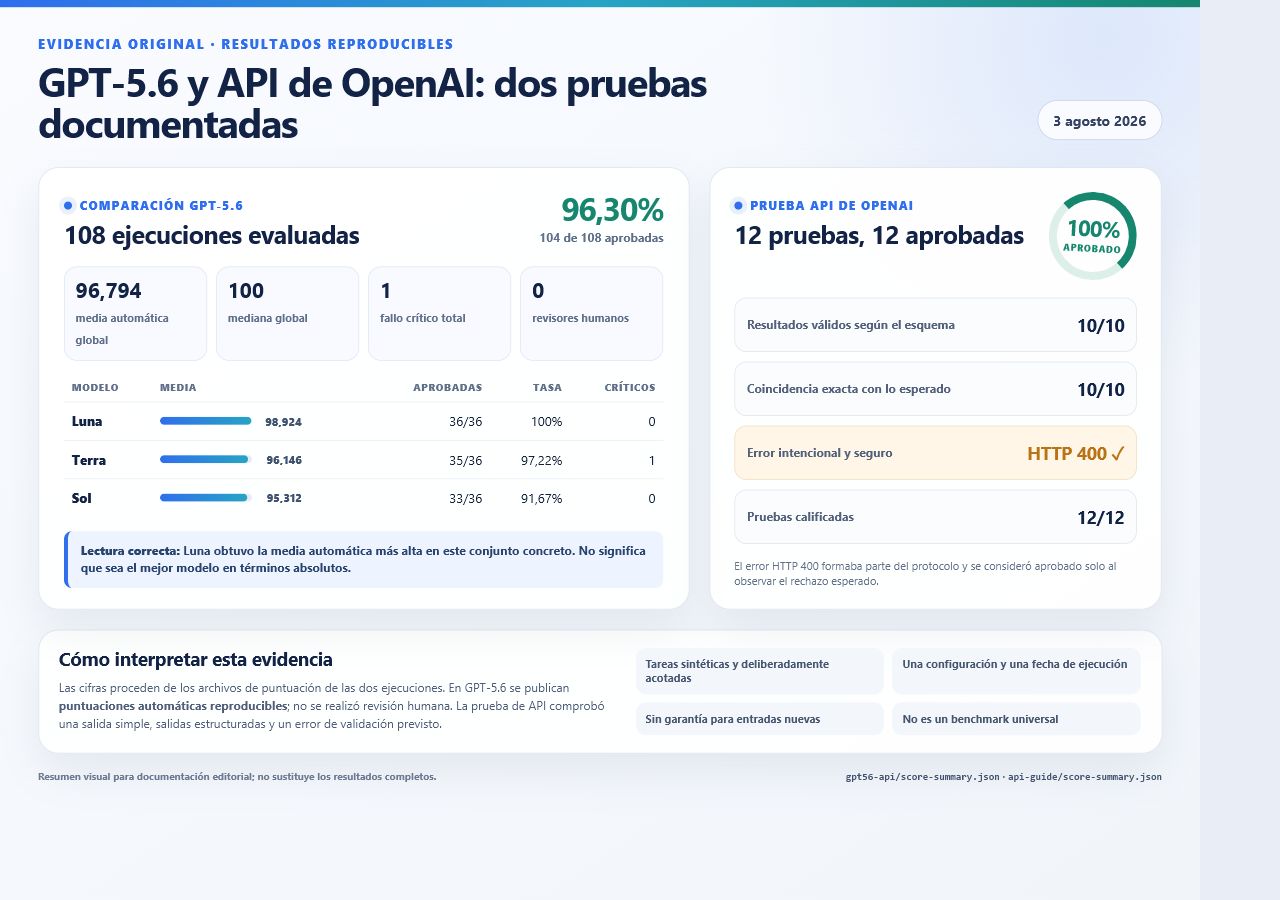
La ejecución consumió 3.041 tokens de entrada, 592 de salida y 130 tokens de razonamiento; el total informado fue 3.633 tokens. Los diez objetos estructurados tuvieron exactamente los cinco campos previstos, tipos válidos y coincidencia exacta con la regla determinista de cada caso.
El HTTP 400 no fue un fallo oculto: era una prueba segura y prevista para confirmar que una solicitud inválida no se interpretara como éxito. En producción no debes enviar max_output_tokens: 0; usa un valor positivo apropiado y trata los errores según su estado.
Alcance del resultado: 12 de 12 describe una sola ejecución, un modelo, datos sintéticos claros y esta configuración. No garantiza que cualquier prompt produzca texto correcto ni que cualquier esquema funcione sin validación. Las latencias dependen de la red y de la carga del servicio.
Para proteger la prueba, los archivos de resultados no guardaron la clave, el encabezado Authorization, cuerpos completos de la API ni identificadores de respuesta o solicitud.
Manejo de errores sin ocultar problemas
Una integración real debe distinguir al menos errores de validación, autenticación, límites y servidor. Registra información suficiente para diagnosticar, pero elimina prompts, respuestas, secretos e identificadores personales que no sean necesarios.
async function generateVerifiedBrief() {
  try {
    const response = await client.responses.create({
      model: "gpt-5.6-luna",
      input: "Devuelve una recomendación breve y verificable.",
      store: false,
      max_output_tokens: 180,
      safety_identifier: safetyIdentifier,
    });

    if (response.status !== "completed") {
      throw new Error(`Respuesta no completada: ${response.status}`);
    }

    return response.output_text;
  } catch (error) {
    const status = Number(error?.status ?? 0);

    if (status === 400) {
      throw new Error("Solicitud inválida: revisa parámetros y esquema");
    }
    if (status === 401 || status === 403) {
      throw new Error("No autorizado: revisa la clave y sus permisos");
    }
    if (status === 429) {
      throw new Error("Límite temporal: aplica espera y reintento controlado");
    }

    throw new Error("No se pudo completar la solicitud");
  }
}

const result = await generateVerifiedBrief();
console.log(result);
Aplica reintentos solo a errores transitorios y con espera exponencial, variación aleatoria y un máximo bajo. No repitas automáticamente un 400: corrige la solicitud. En operaciones que causen efectos externos, añade idempotencia para no duplicar una acción.
Privacidad: qué significa realmente store: false
La documentación oficial de controles de datos indica que los datos enviados a la API no se usan para entrenar los modelos de OpenAI de forma predeterminada, salvo participación voluntaria aplicable. También distingue entre estado de aplicación y registros de supervisión de abuso.
store: false evita el almacenamiento del estado de respuesta aplicable, pero no significa que no exista ninguna retención. Los registros de supervisión de abuso pueden incluir prompts, respuestas o metadatos derivados y conservarse hasta 30 días de forma predeterminada, salvo obligaciones o medidas de protección que requieran más tiempo.
Zero Data Retention es un control adicional sujeto a aprobación de OpenAI y a limitaciones por endpoint y capacidad. No afirmes que tu proyecto tiene ZDR si solo envías store: false. Minimiza los datos, evita enviar secretos y documenta con precisión qué controles están activos.
Seguridad y calidad antes de producción
- Conserva la clave exclusivamente en el servidor y rótala si existe sospecha de exposición.
- Asigna permisos mínimos a la clave y separa desarrollo, pruebas y producción.
- Configura límites de gasto, alertas y límites de solicitudes por usuario.
- Valida longitud, tipo y contenido de la entrada antes de llamar a la API.
- Usa un
safety_identifierestable y seudónimo para usuarios finales individuales. - Fija
max_output_tokensy gestiona el estadoincomplete. - Usa Structured Outputs cuando el sistema dependa de campos y tipos concretos.
- Valida reglas de negocio después del esquema; no ejecutes ciegamente código o acciones sugeridas.
- Mantén revisión humana antes de usos de alto impacto o generación de código sensible.
- Prueba intentos de abuso y entradas adversarias antes de abrir el servicio.
- Registra estados, tiempos y uso de tokens sin guardar claves ni contenido innecesario.
- Revisa periódicamente modelos, precios, límites, documentación y políticas.
Las prácticas oficiales de seguridad recomiendan revisión humana cuando sea posible, especialmente en ámbitos de alto impacto y en generación de código.
Cómo evaluar tu propia integración
- Reúne casos representativos sin datos personales reales.
- Define la respuesta esperada o una rúbrica antes de ejecutar.
- Fija modelo, prompt, esquema, herramientas y límites.
- Registra éxito HTTP, validez, exactitud, latencia, tokens y fallos.
- Incluye casos ambiguos, entradas inválidas y rechazos esperados.
- Revisa manualmente una muestra y separa hechos de preferencias editoriales.
- Repite la evaluación tras cambiar el modelo, prompt, SDK o esquema.
Un “funcionó una vez” no es suficiente para producción. La meta útil es un resultado aceptable y verificable con un costo y una tasa de fallos conocidos.
Preguntas frecuentes sobre la API de OpenAI
¿La clave puede usarse directamente desde el navegador?
No. El usuario podría inspeccionarla y utilizarla fuera de tu aplicación. Envía la solicitud desde un servidor que proteja el secreto y aplique autenticación y límites.
¿store: false activa Zero Data Retention?
No. Son controles distintos. store: false no elimina por sí solo los registros de supervisión de abuso, que pueden conservarse hasta 30 días de forma predeterminada.
¿Structured Outputs garantiza que el contenido sea verdadero?
No. Garantiza adherencia al esquema compatible cuando la respuesta se completa correctamente, pero no demuestra que una cifra, clasificación o afirmación sea correcta. Valida el contenido contra reglas y fuentes.
¿Qué significa el resultado 12 de 12?
Significa que nuestra ejecución superó una solicitud de texto, diez casos estructurados y una comprobación de error intencional. No es una garantía para otros datos, modelos o fechas.
¿La API de OpenAI es gratuita?
No presupongas acceso gratuito ni ilimitado. El precio y los límites dependen del modelo, el proyecto y la cuenta. Consulta la comparación oficial vigente y configura límites de gasto.
¿Qué modelo debo usar?
Empieza con el modelo más económico que alcance el umbral de calidad de tus casos reales. Compara con controles iguales y escala a una variante más capaz solo cuando la mejora medida lo justifique.
Fuentes oficiales
- Inicio rápido de la API de OpenAI
- Guía oficial de Structured Outputs
- Guía del modelo GPT-5.6
- Controles de datos de la plataforma
- Prácticas de seguridad de la API
- Catálogo oficial de modelos
Nota: este sitio es independiente y no es el sitio oficial de OpenAI ni la aplicación oficial de ChatGPT. Los ejemplos son educativos; adapta seguridad, privacidad, validación y cumplimiento a tu aplicación.
Caso IoT: una salida estructurada es una propuesta, no un comando
En IoT, el dispositivo genera telemetría; un gateway autentica y normaliza; el backend comprueba frescura, unidades, permisos y rangos; la API puede devolver una explicación o propuesta; y un motor de políticas decide si la acción está permitida. Las credenciales y los límites físicos permanecen fuera del modelo.
{
  "accion": "proponer_ajuste",
  "dispositivo": "zona-3",
  "valor": 21,
  "unidad": "celsius",
  "requiere_aprobacion": true,
  "motivo": "Temperatura fuera del objetivo configurado"
}
Aunque el objeto cumpla el esquema, el servidor todavía debe validar:
- identidad del dispositivo, usuario, servicio y entorno;
- frescura de la lectura y coherencia de su marca temporal;
- unidad y rango duro definido por el fabricante o controlador;
- lista cerrada de acciones y permisos del solicitante;
- alarmas, bloqueos, mantenimiento y dependencias;
- idempotencia, aprobación y confirmación del estado posterior.
Function calling permite solicitar una función definida por la aplicación; no ejecuta ni autoriza por sí solo un dispositivo. Cerraduras, equipos médicos, vehículos, procesos industriales y sistemas contra incendios deben mantener controles certificados, límites locales y parada segura independientes de la red y del modelo.
MQTT y fallos seguros
Usar MQTT no cifra ni autentica automáticamente la instalación. Aplica transporte protegido, credenciales por dispositivo y permisos por tema; separa telemetría, propuestas y órdenes ejecutables. Diseña para mensajes duplicados y revoca dispositivos retirados.
Si la API no responde, conserva un estado seguro. Si falta una lectura, no inventes el valor. Si la salida incumple el esquema o la aprobación caduca, rechaza la acción. Si el dispositivo no confirma el cambio, alerta y evita reintentos ilimitados.
Referencias: NIST SP 800-213, MQTT 5.0 de OASIS y las prácticas de seguridad de OpenAI.