
Si buscas cómo escribir un informe con ChatGPT, la forma más fiable es usarlo para crear un borrador estructurado y comprobar después cada cifra, fuente e inferencia contra los datos originales. No trates una respuesta fluida como evidencia: OpenAI advierte que ChatGPT puede producir información incorrecta o engañosa y recomienda verificar los datos importantes.
Respuesta breve: define primero la decisión y la audiencia, prepara una fuente limpia, fija las fórmulas fuera del modelo, pide que separe hechos de interpretaciones y revisa el resultado con una lista de control. ChatGPT puede ahorrar trabajo de estructura y redacción, pero la persona que firma el informe conserva la responsabilidad final.
Transparencia: chatgpt-gratis.chat es un sitio independiente y no es el servicio oficial ChatGPT. Para esta guía ejecutamos una prueba fechada mediante OpenAI API, no en la interfaz web de ChatGPT. Publicamos el protocolo, el dataset sintético, las solicitudes, las salidas, las reglas, la revisión editorial y los archivos de verificación. Tres intentos con una sola tarea no representan el rendimiento general del producto.
Esta página se concentra en convertir datos ya documentados en un informe verificable. Para practicar sin información confidencial, puedes abrir un chat de prueba y aplicar la lista de control que aparece más adelante.
Método rápido para hacer informes con ChatGPT
- Define la decisión: quién leerá el informe, qué periodo cubre y qué pregunta debe responder.
- Prepara la evidencia: limpia los datos, documenta columnas, unidades, periodos y sistemas de origen.
- Congela las fórmulas: calcula fuera del modelo una tabla de referencia con numeradores y denominadores.
- Pide un borrador estructurado: separa hechos, interpretaciones, hipótesis, límites y datos ausentes.
- Verifica antes de compartir: busca errores, omisiones, causalidad no demostrada y fuentes inexistentes.
- Registra la versión: conserva entrada, prompt, salida original, correcciones humanas, fecha y responsable.
Qué comprobamos en nuestra prueba original
Diseñamos una tarea acotada: redactar en español neutro un borrador de informe ejecutivo para una empresa ficticia llamada Comercio Faro. El archivo cg-report-synthetic-v2 contiene 18 filas de abril, mayo y junio de 2026, tres regiones y dos canales. Incluye sesiones, pedidos, ingresos, descuentos, reembolsos, gasto publicitario, soporte, entrega y NPS. No contiene clientes, empleados ni resultados empresariales reales.
La prueba solicitó 12 métricas con unidades, numeradores, denominadores e identificadores de evidencia. También exigió separar hechos, interpretaciones y recomendaciones; declarar la incertidumbre; no presentar ingresos como beneficio; y no atribuir causalidad sin un diseño que la permita.
Diseño y controles
- Calculamos el ground truth de forma determinista fuera del modelo.
- Congelamos antes de ejecutar el dataset, el prompt, el esquema, la configuración, las reglas y sus hashes SHA-256.
- El prompt reveló las fórmulas y los grupos de evidencia, pero no los valores calculados. Por eso la prueba mide aplicación de fórmulas y cumplimiento del contrato, no descubrimiento autónomo del método.
- Realizamos tres solicitudes secuenciales, una sola vez cada una y sin corregir ni reintentar una respuesta.
- Guardamos la respuesta del proveedor y una proyección pública depurada antes de evaluar.
- Aplicamos 18 reglas automáticas por ejecución y una revisión editorial humana independiente del evaluador automático.
| Fecha de ejecución | 18 de agosto de 2026, de 13:42:00 a 13:48:11 UTC |
|---|---|
| Interfaz medida | OpenAI Responses API |
| Modelo solicitado | gpt-5.6-sol; las dos respuestas completadas devolvieron el mismo identificador |
| Configuración | reasoning.effort: medium, max_output_tokens: 6000, service_tier: default, store: false, sin herramientas |
| Repeticiones | 3, con el mismo dataset, prompt y esquema congelados |
| Evaluación | 18 reglas automáticas por ejecución, 12 métricas objetivo y 7 decisiones editoriales por salida evaluable |
Usamos Structured Outputs para fijar la forma del JSON. Ese control ayuda a validar la estructura, pero no demuestra por sí solo que el contenido sea correcto. Los cálculos y la trazabilidad se verificaron por separado.
Resultados de la prueba reproducible
La primera solicitud terminó con HTTP 503 porque el servicio estaba sobrecargado. No hubo texto que evaluar y no se hizo un reintento, de modo que esa ejecución quedó como no evaluable: no es correcto contarla como un fallo de calidad del modelo. Las ejecuciones 2 y 3 sí terminaron, reprodujeron exactamente las 12 métricas objetivo y superaron las 18 reglas automáticas.
Después, Ahmed Aly, propietario del sitio, revisó las salidas completas siguiendo siete criterios editoriales registrados: distinción entre ingresos y beneficio, disciplina causal, separación entre hechos e interpretación, coherencia con la evidencia, recomendaciones formuladas como hipótesis, ausencia de hechos o datos ajenos y claridad del español. Las dos salidas evaluables superaron 7 de 7 criterios. No hubo un segundo revisor humano independiente, una limitación que debe conservarse al interpretar el resultado.
| Ejecución | Estado | Métricas | Reglas automáticas | Revisión editorial | Latencia | Tokens entrada/salida | Coste conocido |
|---|---|---|---|---|---|---|---|
| r1 | HTTP 503; no evaluable | — | 0 pass, 1 fail de puerta y 17 no ejecutadas | No evaluable | 2,433 s hasta el error | — | Desconocido |
| r2 | Completada | 12/12 exactas | 18/18 | 7/7; pass | 298,603 s | 2.747 / 5.397 | USD 0,163297 |
| r3 | Completada | 12/12 exactas | 18/18 | 7/7; pass | 70,064 s | 2.747 / 5.126 | USD 0,155167 |
En conjunto hubo 36 reglas superadas, 1 fallo de puerta y 17 reglas no ejecutadas sobre 54 posiciones posibles. La cifra útil no es «36 de 54» como si todas fueran observaciones de calidad: r1 no produjo salida, mientras que r2 y r3 consiguieron 18 de 18 cada una.
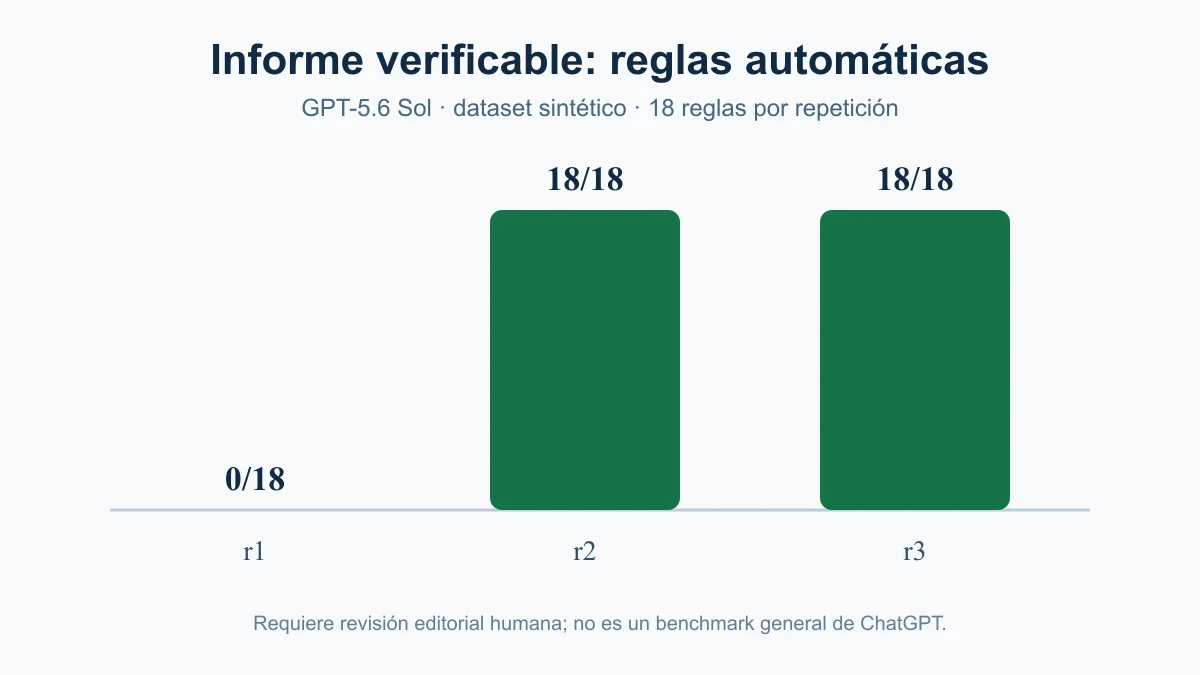
cg-report-synthetic-v2. r1 muestra 0/18 porque HTTP 503 impidió obtener una salida; r2 y r3 superaron 18/18. La revisión editorial humana es una capa separada y no aparece como barra.Las 12 cifras que se verificaron
Las dos salidas completadas presentaron los 12 valores siguientes con sus unidades, numeradores, denominadores y filas de evidencia correctos. Mostrar la fórmula permite comprobar el dato sin confiar en la redacción.
| Métrica | Valor verificado | Cálculo o alcance |
|---|---|---|
| Ingresos netos totales | USD 148.480 | 158.800 − 6.330 − 3.990 |
| Conversión agregada | 4,62% | 2.774 pedidos / 60.000 sesiones × 100 |
| Valor medio neto por pedido | USD 53,53 | 148.480 / 2.774 |
| Tasa de descuentos | 3,99% | 6.330 / 158.800 × 100 |
| Tasa de reembolsos | 2,51% | 3.990 / 158.800 × 100 |
| Resolución dentro del SLA | 85,93% | 684 / 796 × 100 |
| Entrega ponderada por pedido | 3,29 días | 9.120 días acumulados / 2.774 pedidos |
| NPS agregado | 48,94 puntos | (602 promotores − 140 detractores) / 944 respuestas × 100 |
| Cambio de conversión de abril a junio | 0,30 puntos porcentuales | 4,77% − 4,47% |
| Ingresos netos del canal pagado | USD 70.550 | Ingresos brutos menos descuentos y reembolsos de las 9 filas del canal |
| Gasto publicitario del canal pagado | USD 13.800 | Suma del gasto de las 9 filas del canal |
| ROAS neto descriptivo | 5,11 | 70.550 / 13.800 |
Límite esencial: los ingresos netos y el ROAS de este archivo no permiten determinar beneficio, margen o rentabilidad porque faltan costes de producto y costes operativos. Tampoco permiten afirmar que la publicidad causó los ingresos observados.
Coste y latencia observados
El coste conocido de las dos respuestas completadas fue USD 0,318464. La facturación de r1 quedó desconocida; para no fingir un cero, el registro reservó un límite conservador de USD 0,2495. Al sumarlo al coste conocido, el techo contable de la ejecución fue USD 0,567964. Esta segunda cifra no es un cargo confirmado.
Las latencias de las dos respuestas completadas fueron muy distintas: 298,603 y 70,064 segundos. Son observaciones fechadas de esta configuración, no promesas sobre velocidad ni precio. Las tarifas, el modelo, la carga, la caché y la longitud pueden cambiar.
Qué significan —y qué no— estos resultados
- Sí muestran que, en las dos salidas evaluables, el modelo aplicó las fórmulas proporcionadas, devolvió las 12 métricas exactas, mantuvo la trazabilidad exigida y superó la revisión editorial registrada.
- No muestran una tasa general de exactitud de ChatGPT, porque solo se probó un modelo, un prompt, un dataset sintético y una fecha.
- No miden si el modelo puede descubrir por sí solo las fórmulas, porque el prompt las proporcionó.
- No convierten Structured Outputs en una garantía semántica: el esquema controla campos y tipos, no la verdad de una conclusión.
- No sustituyen una revisión profesional en informes médicos, legales, financieros, laborales, de seguridad o cumplimiento.
Advertencia: tres solicitudes sobre un único conjunto sintético no permiten afirmar que el modelo siempre escriba informes completos, exactos o rápidos.
Cómo escribir un informe con ChatGPT paso a paso
1. Define el objetivo, la audiencia y la decisión
Evita instrucciones abiertas como «resume estos datos». Explica quién leerá el documento, qué periodo cubre, qué decisión debe apoyar y qué queda fuera del alcance. Un informe para dirección necesita síntesis y decisiones; un anexo técnico necesita fórmulas, evidencia y excepciones.
2. Prepara una fuente limpia y documentada
Elimina duplicados, normaliza fechas y monedas, resuelve campos vacíos y crea un diccionario de datos. Si «ingresos» puede significar bruto o neto, acláralo antes de redactar. Cuando trabajes con tablas, consulta también la guía de ChatGPT para Excel con archivos XLSX y CSV.
3. Calcula una referencia fuera del modelo
Define cada indicador por escrito. Para un porcentaje, conserva numerador y denominador; para un promedio, documenta la ponderación; para una variación, distingue cambio relativo de puntos porcentuales. Usa una hoja o un script independiente para obtener el resultado esperado y no lo cambies después de ver la respuesta.
4. Separa hechos, interpretaciones e hipótesis
Un hecho puede ser «la conversión fue 4,62%». Una interpretación puede señalar que junio quedó 0,30 puntos porcentuales por encima de abril, pero no explicar por qué. Una recomendación responsable debe formularse como hipótesis a probar, con una acción, una métrica de éxito y un límite de decisión.
5. Exige incertidumbre y datos ausentes
Indica qué conclusiones no pueden sostenerse. Si faltan coste de producto, margen, inventario, cohortes o un grupo de control, el borrador debe decirlo. Una frase útil es: «no se puede determinar con este conjunto de datos».
6. Genera un borrador, no una versión final
Define formato, longitud, unidades y secciones, pero conserva la etiqueta de borrador. OpenAI recomienda mantener supervisión humana, especialmente cuando el resultado puede afectar a una decisión. La persona revisora debe poder consultar las fuentes originales.
7. Verifica cifras, omisiones, fuentes y causalidad
No busques solo números incorrectos: una métrica omitida puede cambiar la interpretación. Comprueba etiquetas, periodos, regiones, monedas, unidades, fórmulas y denominadores. Abre cada fuente citada y confirma que existe y respalda exactamente la afirmación. Si la evidencia está en documentos, el método de análisis de PDF con ChatGPT ayuda a conservar la página de origen.
8. Registra la versión aprobada
Conserva el archivo de entrada, el prompt, la salida original, la fecha, el producto o modelo, la tabla de comprobación y los cambios humanos. Así podrás explicar de dónde salió cada afirmación y repetir la evaluación cuando cambien los datos.
Prompt para redactar un informe con ChatGPT
Adapta este ejemplo a tu tarea. No pegues datos sensibles y elimina cualquier regla que no corresponda a tu fuente:
Actúa como analista y prepara un borrador sujeto a revisión humana.

Objetivo: redactar un informe para [audiencia] sobre [pregunta] durante [periodo].

Fuente: usa exclusivamente el archivo y el diccionario que adjunto. No añadas hechos, fuentes ni comparaciones externas.

Reglas:
1. Separa “Hechos calculados”, “Interpretaciones” y “Hipótesis para probar”.
2. Para cada cifra material, indica unidad, periodo y filas de evidencia.
3. Para cada porcentaje, muestra fórmula, numerador y denominador.
4. Usa estas fórmulas aprobadas: [pegar fórmulas].
5. No presentes ingresos como beneficio ni una relación observada como causalidad.
6. Si faltan datos, escribe: “no se puede determinar con este conjunto de datos”.
7. Enumera las limitaciones y la información ausente.
8. Escribe en español neutro y respeta la longitud [mínimo–máximo].

Estructura:
- alcance y método;
- resumen ejecutivo de 3 a 5 puntos;
- hechos calculados;
- interpretaciones con incertidumbre;
- tres hipótesis con acción y métrica de éxito;
- limitaciones y datos ausentes;
- apéndice con todas las cifras citadas.
Un prompt preciso reduce ambigüedad, pero no garantiza exactitud. La guía oficial de prompts ayuda a orientar la salida; la evaluación debe diseñarse por separado.
Lista de verificación antes de compartir el informe
- ¿Cada cifra coincide con la fuente y conserva periodo, región, unidad, numerador y denominador?
- ¿Aparecen todas las métricas requeridas, no solo las que resultan fáciles de calcular?
- ¿Los ingresos se distinguen de beneficio, margen y rentabilidad?
- ¿El texto evita convertir correlación o cambio temporal en causa?
- ¿Cada enlace existe, es la fuente adecuada y sostiene la afirmación concreta?
- ¿Las recomendaciones son hipótesis comprobables y no hechos presentados sin evidencia?
- ¿Se declaran los datos ausentes, los supuestos y las limitaciones?
- ¿Una persona competente revisó el informe completo y registró su decisión?
Errores frecuentes al usar ChatGPT para informes
- Confundir forma con verdad: un JSON válido o un texto profesional todavía puede contener una conclusión incorrecta.
- Revisar errores, pero no omisiones: una salida puede acertar todo lo que menciona y aun así dejar fuera un indicador decisivo.
- Promediar promedios sin ponderación: los segmentos con distinto volumen no deben recibir el mismo peso por defecto.
- Confundir porcentaje con puntos porcentuales: pasar de 4,47% a 4,77% son 0,30 puntos porcentuales, no un aumento relativo de 0,30%.
- Tratar ingresos como beneficio: sin costes de producto y operación no se puede determinar rentabilidad.
- Inventar una causa: que dos métricas cambien juntas no prueba que una haya causado la otra.
- Ocultar un error técnico: un HTTP 503 debe registrarse como intento no evaluable, no sustituirse en silencio por una ejecución adicional.
Privacidad y datos sensibles
Nuestra prueba usó datos sintéticos y configuró store: false. Esto no equivale por sí solo a retención cero. Revisa los controles de datos documentados por OpenAI, las condiciones del producto y las políticas de tu organización antes de enviar información real.
- No incluyas claves API, contraseñas, cookies, datos bancarios ni identificadores innecesarios.
- Minimiza o anonimiza datos personales y limita el archivo al periodo necesario.
- Comprueba la base legal, los permisos de acceso y las reglas internas antes de procesar información confidencial.
- Separa el archivo público de evidencia de cualquier registro privado del proveedor.
Descargar los datos y repetir la prueba
La versión pública se fija en dos lugares: el commit inmutable del repositorio permite inspeccionar archivos y código; el registro archivado con DOI permite descargar el paquete citado.
- Paquete:
write-report-gpt-5.6-sol-benchmark-v1.0.0.zip. - SHA-256 del ZIP:
a253dd27a66790b5675e87e2d25afaf237d892b16247ea5c3332897637df3875. - Entradas: dataset, diccionario, ground truth, prompt, esquema y configuración congelada.
- Evidencia: intenciones de intento, solicitudes, respuestas depuradas, metadatos y el registro del HTTP 503.
- Evaluación: resultados por regla, revisión editorial, resumen para el artículo, gráfico, pruebas y checksums.
- Licencias: MIT para el código y CC BY 4.0 para datos, resultados, informes y gráficos.
Sin llamar a la API, puedes recalcular el ground truth, ejecutar las pruebas y comprobar los hashes del paquete. Volver a llamar al modelo es otra operación: puede producir un texto distinto, consume crédito y debe realizarse con un límite de coste y una clave temporal propia. «Reproducible» aquí significa que los cálculos, reglas y archivos publicados pueden volver a verificarse; no promete una salida idéntica de un sistema probabilístico.
Cuándo no basta un borrador generado
Un informe médico, legal, financiero, laboral, de crédito, seguridad o cumplimiento puede tener consecuencias importantes. En esos casos, la revisión debe hacerla una persona con competencia y autoridad suficientes. Este método no sustituye asesoramiento profesional, auditoría, validación estadística ni controles internos.
Para informes de riesgos cibernéticos, conserva por separado activo, versión, evidencia, severidad, propietario, plazo y criterio de cierre. El modelo puede ordenar el registro y redactar un resumen, pero no debe estimar severidad, certificar cumplimiento ni cerrar un riesgo sin una regla aprobada y una revisión especializada. Esta prueba de informe comercial no midió seguridad ni cumplimiento.
Preguntas frecuentes
¿ChatGPT puede escribir un informe completo?
Puede producir un borrador completo y bien estructurado, pero «completo» no significa verificado. En nuestra prueba, las dos salidas evaluables incluyeron las 12 métricas exigidas; la primera solicitud no produjo texto por un HTTP 503. Es una observación pequeña, no una garantía para otros datos o tareas.
¿Qué significa superar 18 de 18 reglas?
Significa que una salida cumplió las propiedades automáticas definidas antes de ejecutar: estructura, valores, unidades, numeradores, denominadores, evidencia, límites y otros controles. No equivale por sí solo a aprobación editorial. Por eso revisamos también cada salida completa con siete criterios humanos.
¿La prueba demuestra que GPT-5.6 Sol siempre acierta?
No. Solo describe tres solicitudes con un dataset sintético, un prompt, una configuración y una fecha. Dos produjeron salidas evaluables y una terminó en HTTP 503. No mide la aplicación ChatGPT, otros modelos, archivos reales ni tareas de distinta complejidad.
¿Cuánto costó la prueba?
El coste conocido de las dos respuestas completadas fue USD 0,318464. Como no se confirmó el coste del intento que terminó con 503, el registro añadió una reserva conservadora y fijó un máximo contable de USD 0,567964. No debe interpretarse como precio futuro ni como factura confirmada por ese máximo.
¿Cómo evito que invente datos?
Limita la fuente, define fórmulas y unidades, exige evidencia e incertidumbre y compara la salida con una referencia calculada fuera del modelo. Estas medidas reducen el riesgo, pero no ofrecen una garantía absoluta. OpenAI también recomienda verificar la información importante.
¿Puedo repetir exactamente el resultado?
Puedes recalcular exactamente las métricas, ejecutar las mismas reglas y verificar la integridad de los archivos. Una nueva llamada al modelo puede devolver otro texto aunque use la misma entrada, por lo que debe registrarse como una ejecución nueva y no como sustitución silenciosa de la original.
Fuentes oficiales y transparencia editorial
- OpenAI: exactitud y necesidad de verificar las respuestas de ChatGPT.
- OpenAI: ficha del modelo GPT-5.6 Sol.
- OpenAI: Structured Outputs.
- OpenAI: diseño y uso de evaluaciones.
- OpenAI: prácticas de seguridad y supervisión humana.
- OpenAI: controles de datos de la API.
Las páginas oficiales documentan el producto, la interfaz y sus controles; no validan nuestros resultados. Los resultados proceden de los archivos de ejecución y del evaluador publicados con la prueba.
Registro editorial: revisor humano y propietario del sitio, Ahmed Aly. Ejecución: 18 de agosto de 2026 (UTC). Revisión humana registrada: el propietario del sitio revisó las tres ejecuciones; r1 quedó no evaluable y r2/r3 pasaron. No se registró un segundo revisor humano independiente. Última comprobación declarada de las fuentes oficiales: 18 de agosto de 2026.
Conclusión
La forma más segura de escribir un informe con ChatGPT es tratar la salida como una capa de redacción sobre un sistema de verificación independiente. En esta prueba, las dos respuestas evaluables reprodujeron las 12 métricas, superaron 18 de 18 reglas automáticas y pasaron la revisión editorial; una solicitud no produjo salida por HTTP 503. El resultado útil no es una promesa sobre el modelo, sino un flujo que puedes auditar: datos definidos, fórmulas congeladas, prompt restrictivo, borrador, verificación automática, revisión humana y registro de evidencia.