
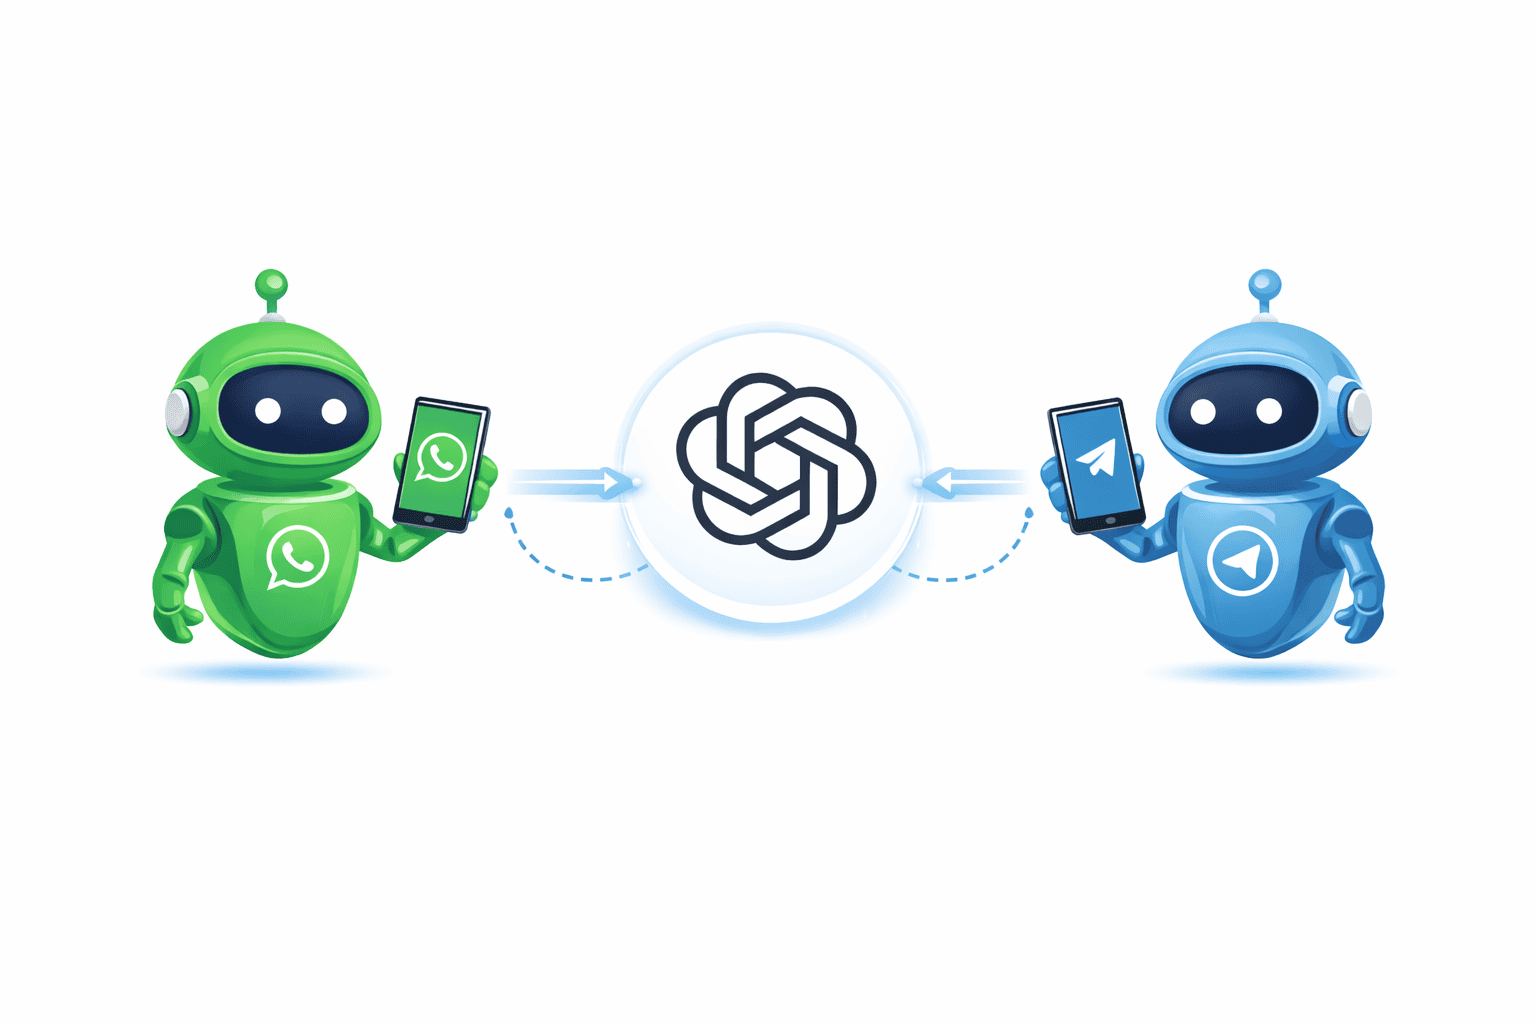
Un bot de WhatsApp o Telegram con OpenAI recibe mensajes mediante la API oficial de la plataforma, los procesa en un backend propio y envía una respuesta generada con la API de OpenAI. No existe una conexión directa y mágica entre “ChatGPT” y estas aplicaciones: tú operas la integración, proteges las credenciales y decides qué datos se envían.
Esta guía, revisada el 3 de agosto de 2026, utiliza la Responses API y la familia GPT‑5.6. Las políticas, versiones de Graph API, límites y precios de WhatsApp, Telegram y OpenAI pueden cambiar. Verifica siempre los paneles y documentos oficiales antes de lanzar un bot a usuarios reales.
Arquitectura recomendada
Usuario → WhatsApp o Telegram → webhook HTTPS → tu backend
       → OpenAI Responses API → validación → API de mensajería → usuario
El webhook debe confirmar la recepción con rapidez. Para cargas reales, coloca el trabajo de IA en una cola y evita que un timeout de OpenAI provoque reenvíos duplicados desde la plataforma. Registra el identificador del evento y aplica idempotencia antes de generar o enviar otra respuesta.
Requisitos para cada plataforma
| Plataforma | Credenciales | Recepción | Envío |
|---|---|---|---|
| Telegram | Token creado con BotFather | setWebhook o getUpdates; no se usan a la vez | Método sendMessage de Bot API |
| WhatsApp Cloud API | Token de Meta, aplicación y número configurado | Webhook verificado y suscrito a eventos | Endpoint /{phone-number-id}/messages de Graph API |
Telegram exige que el usuario inicie la conversación o añada el bot a un chat permitido. En WhatsApp, comprueba en la documentación oficial de Meta y en el panel de tu cuenta las reglas vigentes para consentimiento, plantillas y ventanas de conversación antes de enviar mensajes. No publiques un plazo o requisito concreto sin citar la política y la versión aplicables, y no automatices mensajes no solicitados.
Paso 1: función común para generar respuestas
Instala el SDK oficial con npm install openai, guarda la clave en OPENAI_API_KEY y define SAFETY_ID_SECRET con un valor aleatorio largo conservado únicamente en el servidor. Para un bot general, GPT‑5.6 Terra puede servir como punto de partida equilibrado; prueba Sol o Luna si tus evaluaciones muestran que encajan mejor.
import { createHmac } from "node:crypto";
import OpenAI from "openai";

const openai = new OpenAI({ apiKey: process.env.OPENAI_API_KEY });

function crearSafetyIdentifier(canal, usuarioId) {
  const secret = process.env.SAFETY_ID_SECRET;
  if (!secret) throw new Error("SAFETY_ID_SECRET no configurado");

  const digest = createHmac("sha256", secret)
    .update(canal + ":" + String(usuarioId))
    .digest("hex")
    .slice(0, 56);

  return "msg_" + digest;
}

export async function generarRespuesta(texto, canal, usuarioId) {
  const limpio = String(texto || "").trim().slice(0, 4000);
  if (!limpio) return "Escribe una pregunta para poder ayudarte.";

  const respuesta = await openai.responses.create({
    model: process.env.OPENAI_MODEL || "gpt-5.6-terra",
    instructions:
      "Responde en español neutral, con claridad. No inventes datos; " +
      "si falta contexto, pide una aclaración breve.",
    input: limpio,
    max_output_tokens: 600,
    store: false,
    safety_identifier: crearSafetyIdentifier(canal, usuarioId),
  });

  if (respuesta.status === "incomplete") {
    return "No pude completar la respuesta dentro del límite. Formula una pregunta más breve.";
  }

  return respuesta.output_text || "No pude generar una respuesta.";
}
max_output_tokens: 600 limita el presupuesto máximo de salida —incluidos los tokens de razonamiento— y el ejemplo contempla una respuesta incompleta. safety_identifier recibe un HMAC estable y seudónimo derivado del canal y del identificador del usuario; no envía a OpenAI el número de teléfono, el chat_id, el nombre, el correo ni otro identificador personal sin transformar. store: false evita almacenar la respuesta para recuperación posterior, pero no equivale por sí solo a Zero Data Retention. Para conversaciones, conserva únicamente el contexto necesario y sepáralo por usuario.
Paso 2: webhook seguro para Telegram
Configura el webhook con una URL HTTPS y un secret_token. Telegram enviará ese valor en la cabecera X-Telegram-Bot-Api-Secret-Token. Valídala antes de leer el mensaje.
app.post("/webhooks/telegram", async (req, res) => {
  if (req.get("X-Telegram-Bot-Api-Secret-Token") !==
      process.env.TELEGRAM_WEBHOOK_SECRET) {
    return res.sendStatus(401);
  }

  const mensaje = req.body?.message;
  const chatId = mensaje?.chat?.id;
  const texto = mensaje?.text;
  res.sendStatus(200);

  if (!chatId || !texto) return;

  try {
    const reply = await generarRespuesta(texto, "telegram", chatId);
    await fetch(
      `https://api.telegram.org/bot${process.env.TELEGRAM_BOT_TOKEN}/sendMessage`,
      {
        method: "POST",
        headers: { "Content-Type": "application/json" },
        body: JSON.stringify({ chat_id: chatId, text: reply }),
      }
    );
  } catch (error) {
    console.error("telegram_processing_failed");
  }
});
En un sistema con volumen, responde 200, guarda el evento y procésalo en una cola. El ejemplo inicia el trabajo después de confirmar, pero un proceso efímero podría finalizar antes; una cola persistente evita esa pérdida. Telegram también ofrece getWebhookInfo para revisar errores y actualizaciones pendientes.
Paso 3: verificación y mensajes en WhatsApp
Meta realiza una solicitud GET para verificar el endpoint. Compara el token recibido con uno secreto que controles y devuelve el desafío únicamente cuando coincida.
app.get("/webhooks/whatsapp", (req, res) => {
  const modo = req.query["hub.mode"];
  const token = req.query["hub.verify_token"];
  const desafio = req.query["hub.challenge"];

  if (modo === "subscribe" &&
      token === process.env.WHATSAPP_VERIFY_TOKEN) {
    return res.status(200).send(desafio);
  }
  return res.sendStatus(403);
});
Para eventos POST, valida además la firma enviada por Meta conforme a su documentación de webhooks. Extrae el identificador del mensaje, el remitente, el texto y el phone_number_id del payload. Después de procesar el evento, envía la respuesta con la versión de Graph API configurada en tu entorno:
async function enviarWhatsApp(phoneNumberId, destinatario, texto) {
  const version = process.env.META_GRAPH_VERSION;
  const url = `https://graph.facebook.com/${version}/${phoneNumberId}/messages`;

  const respuesta = await fetch(url, {
    method: "POST",
    headers: {
      Authorization: `Bearer ${process.env.WHATSAPP_ACCESS_TOKEN}`,
      "Content-Type": "application/json",
    },
    body: JSON.stringify({
      messaging_product: "whatsapp",
      to: destinatario,
      type: "text",
      text: { body: texto },
    }),
  });

  if (!respuesta.ok) throw new Error("whatsapp_send_failed");
}
Tras validar la firma y extraer los campos del evento, genera la respuesta con el identificador seudónimo del remitente y envíala:
const reply = await generarRespuesta(texto, "whatsapp", remitente);
await enviarWhatsApp(phoneNumberId, remitente, reply);
No fijamos una versión concreta de Graph API porque Meta mantiene un calendario de versiones y retirada. Declárala explícitamente, pruébala y actualízala siguiendo el aviso del panel. No registres tokens ni el cuerpo completo de mensajes de clientes.
Memoria, privacidad y consentimiento
- Informa de que el mensaje será procesado por servicios de mensajería y por OpenAI.
- Solicita solo la información necesaria y bloquea contraseñas, números completos de pago y secretos.
- Define una retención limitada para mensajes, identificadores, errores y métricas.
- Ofrece una ruta clara hacia una persona cuando el bot no pueda resolver el caso.
- No uses respuestas generadas como asesoría médica, legal o financiera sin controles adecuados.
Controles indispensables en producción
Aplica límites por usuario, tamaño máximo, timeout y reintentos con espera progresiva. Modera entradas cuando el caso lo requiera y valida la salida antes de ejecutar acciones. Separa respuestas informativas de operaciones como cancelar un pedido o modificar una cuenta: estas últimas necesitan autenticación, autorización y confirmación explícita.
Mide eventos recibidos, duplicados, latencia, errores de plataforma, errores de OpenAI y transferencias a agentes humanos. No publiques porcentajes de mejora hasta obtenerlos con tus propios datos y una metodología documentada.
Diseño de conversación y escalado humano
El primer mensaje debe identificar que responde un asistente automatizado, explicar su alcance y ofrecer una salida. Mantén las respuestas breves para pantallas pequeñas y utiliza botones o comandos cuando la plataforma los admita. Antes de pedir datos, explica para qué son necesarios. Si el usuario cambia de tema o la intención no está clara, pide una sola aclaración en lugar de inventar.
Define reglas objetivas para transferir la conversación: solicitud explícita de una persona, baja confianza, dos intentos fallidos, lenguaje de urgencia o una acción que requiere identidad verificada. Al escalar, entrega al agente un resumen revisable y los mensajes estrictamente necesarios; no presentes el resumen generado como un hecho sin permitir que consulte la conversación original autorizada.
Para el diseño general, consulta la arquitectura de automatización con controles. Si el bot deja de responder, comprueba primero el estado publicado de los servicios antes de cambiar el código.
Fallos habituales
- Respuestas duplicadas: falta idempotencia o la plataforma reenvía un evento cuyo 200 llegó tarde.
- Telegram no entrega: revisa
getWebhookInfo, HTTPS, certificado, puerto permitido ysecret_token. - WhatsApp rechaza el envío: comprueba versión de Graph API, permisos, token, número, formato y política de mensajería aplicable.
- Contexto de otro usuario: la sesión está indexada de forma global o con un identificador reutilizado.
- Coste inesperado: faltan límites de longitud, cuotas, caché deliberada o una ruta de salida para conversaciones repetitivas.
Conclusión
Una integración sólida utiliza las APIs oficiales, valida cada webhook, mantiene las credenciales en el servidor y trata la generación como una etapa controlada. Telegram permite empezar con menos configuración; WhatsApp requiere la configuración empresarial y las políticas de Meta. En ambos casos, Responses API y GPT‑5.6 deben introducirse después de diseñar consentimiento, seguridad, idempotencia y escalado humano.